

AIによる「再帰的自己改善」への懸念、アンソロピックとOpenAIのトップは開発の減速で一致
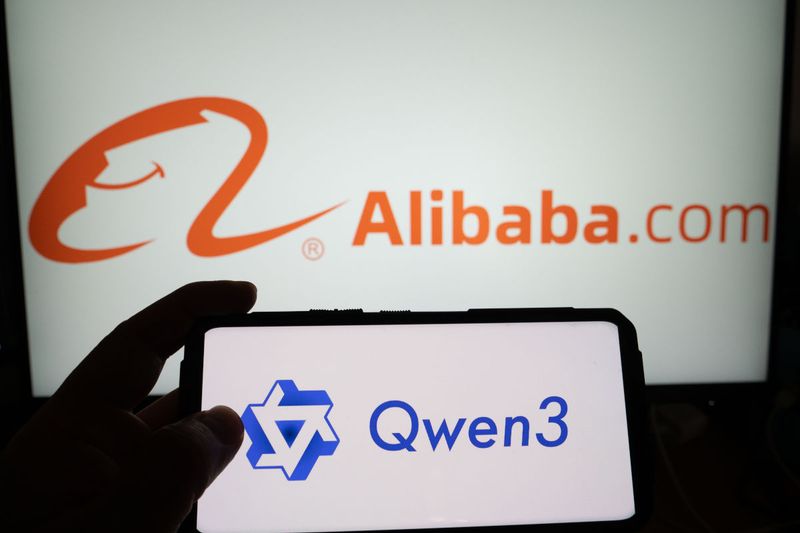
Qwenのテストでモデルが「再帰的自己改善」(recursive self-improvement)を行うことが示されたわけではない。再帰的自己改善とは、人間の手を介さずに、モデルが自らの次のバージョンを生み出すことだ。
最先端のAI開発企業は、制御不能に陥りかねないシステムの開発を、無謀な速さで進めているのではないか。現在激しく交わされているこの論争の核心にあるのが、再帰的自己改善である。この週末には、AnthropicのCEOダリオ・アモデイとOpenAIのCEOサム・アルトマンが、「最先端AIの開発ペースを調整する」(pace the frontier)ことで足並みをそろえた。より慎重に開発を進めることで、安全面での破滅的な事態を避けたいという考えである。
公表する米国企業と消極的な中国企業──ただしQwenだけの問題ではない
米国の最先端AI開発企業は、自社のAIエージェントが制御を外れた行動をとった際に、その事実を公表してきた。一方、中国の競合企業は、そうした情報の開示にそれほど積極的ではない。
とはいえ、ハッカーがQwenを悪用していることは、これまでの調査で明らかになっている。フィッシングメールの作成や、標的とするネットワーク基盤の偵察(reconnaissance。攻撃に先立って、標的のシステム構成や弱点を調べ上げること)といった用途だ。
ラハブによると、Irregularがこの問題をアリババに伝えなかったのは、Qwenに限らず広く当てはまるセキュリティ上の抜け穴だからだという。Irregularは西側諸国以外の組織とは契約を結んでおらず、Qwenを調べたのも純粋に研究のためだった。
懸念すべきは超知能より、人間のように学び変わり続けるAI
ラハブが今心配しているのは、超知能(superintelligence。人間の知能をはるかに上回るAI)が人間の制御を振り切ってしまうことではない。むしろ懸念しているのは、エージェントが周囲の環境の変化から絶えず学び、それに適応した上で、予測できない形でモデルを作り替えてしまうことだ。
「人間とよく似た形で、絶えず変化し、適応していけるシステムが現れれば、そのシステムが到達しうる高度さは、相当なものになるでしょう」とラハブはいう。「私たちがこれまで築いてきた防御策の多くは、こうしたことが現実に起こりうる世界への備えができていません」。