

サンタクララで開催された「AI Infra Summit」において、NVIDIA(エヌビディア)のイアン・バックとIntel(インテル)のリップブ・タンが相次いで登壇した。印象的だったのは、両者のセッションにおいて、同じハードウェアへの言及が何度も繰り返されたことだ。この3年間、AIインフラの話題はGPUを中心に展開されてきた。しかし今週、GPUブームを決定づけた企業のリーダーと、CPUの代名詞とも言える企業のリーダーが、まったく同じ変化について語った。それは、AIエージェントが汎用演算処理に対して、莫大な新たな需要を生み出しているということだ。
ゴールドマン・サックス・リサーチによると、消費者や企業が「エージェンテックAI(自律型AI)」を取り入れるにつれ、トークン消費量は2030年までに24倍に急増すると予測されている。
バックは、驚くべき比較を用いてこの変化を説明した。2023年における一般的なAIチャットでは、人間が合間に読んで入力するというプロセスを挟みながら、約1000トークン、3回のやり取りが行われていた。これに対し、彼が提示したエージェントによるワークロードでは、1回の平均的なリクエストで14万2000トークン、65回ものやり取り(ターン)が発生するという。人間が最終結果を待つ間も、エージェントは自律的に稼働し続ける。
これが、コンピューティングのあり方を変えようとしている。
なぜCPUがAIエージェントにとって重要なのか
GPUは、大量の数学的計算を並列処理することに長けている。そのため、モデルの学習やトークンの生成には最適である。
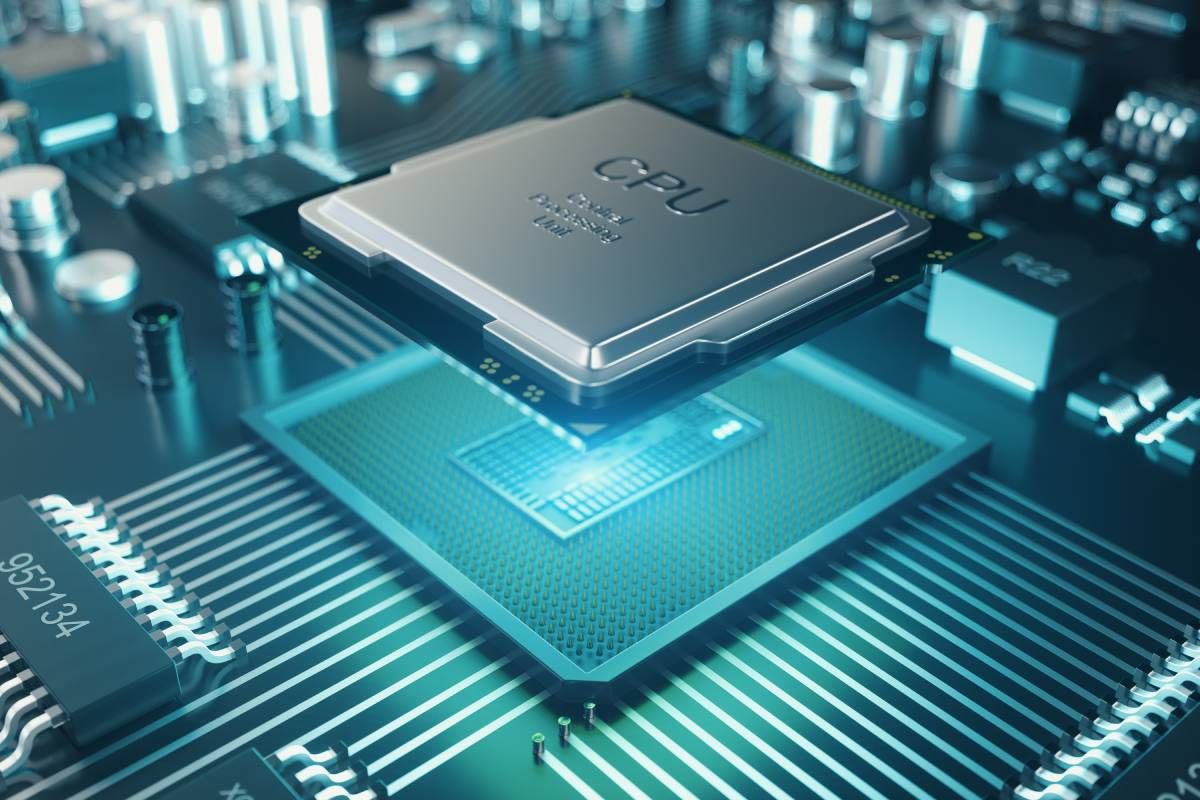
一方、CPUはモデルを取り巻く、多種多様で分岐の多い処理の大部分を担う。安全なサンドボックス(仮想的な実行環境)の立ち上げ、コードのコンパイル、Gitの実行、ファイルの検索、コンテキストの取得、ツールの呼び出し、結果の検証、そして次に実行すべき処理の決定などだ。個々のステップは小規模かもしれないが、エージェントは1つのタスクを実行する間に、これらを何十回も繰り返す。
NVIDIAは現在、これを「AIファクトリーにおける新たなCPUの重要局面(CPU moment)」と表現している。同社がこの変化について説明した内容によると、サンドボックスの作成、ツールの呼び出し、オーケストレーション(統合的な制御)、そしてロングコンテキスト(長大な文脈)の検索はいずれも、CPUに高い負荷をかけるという(NVIDIAによる説明を参照)。
同社の新型CPU「Vera(ヴェラ)」は、まさにこうしたワークロード向けに設計されている。バックが提示した実績によると、Veraは80以上のエージェントタスクにおいて処理速度が1.6倍高速化し、コンパイルやGitのループ処理では最大2倍のパフォーマンス向上を記録した。また、検索エンジン大手のPerplexity(パープレキシティ)は、安全なエージェント用サンドボックスの起動時間が1.9倍高速化したと報告している。これは極めて重要なことだ。なぜなら、短時間のタスクにおいては、サンドボックスの作成自体に、その中で行われる実際の処理よりも長い時間がかかる場合があるからだ。
インテルも同様のCPUへのシフトを予測
インテルからのメッセージも同様に明確だった。タンは聴衆に対し、インテルは四半期ごとにCPUの供給枠を割り当てており、他社のCEOから供給増を求める電話が殺到していると語った。彼はこの需要の背景に、強化学習、エージェントのオーケストレーション、そしてCPUとGPUの比率の変化があると指摘した。
今年初め、タンはこの広範な移行について次のように語っていた。「AIの次なる波は、ファウンデーションモデルから推論、そしてエージェント型へと、知性をエンドユーザーのより近くへと引き寄せるだろう」。インテルは、このシフトによって同社製CPUの需要が大幅に増加していることを、第1四半期の決算報告で明らかにしている。
ここには大きな皮肉がある。GPUという言葉を世に広めたNVIDIAが、初のカスタムCPUを出荷し、単体のCPUシステムを提供しているのだ。その一方で、過去のコンピューティング時代のために作られた企業として片付けられがちだったインテルが、最も明確なAIの追い風を掴んでいる可能性がある。
OpenAIの新型CPU
OpenAIの新型チップ「Jalapeño(ハラペーニョ)」は、CPUをめぐるストーリーに重要な展開をもたらしている。Jalapeñoは、Broadcom(ブロードコム)と共同開発されたカスタム推論アクセラレーター、すなわちASIC(特定用途向け集積回路)である。その強みは、OpenAIがハードウェア設計を、自社のモデル、カーネル、コンパイラ、メモリ、ネットワーキング、および配信(サービング)用ソフトウェアと極めて緊密に連携させられる点にある。
同社はすべてのレイヤーを自社で運用しているため、エンジニアはモデルの速度がどこで低下するのか、どこで過剰な電力を消費するのか、あるいはどこでデータ移動が多すぎるのかを正確に把握し、そのパターンに合わせてチップを設計することができる。
OpenAIによると、Jalapeñoは業界全体の現在および将来の大規模言語モデル(LLM)を実行できるため、特定の単一モデルに縛られることはない。その本質的な強みは、顧客、ワークロード、および製品ロードマップが密接に統合されていることにあり、これによりチップとOpenAIのモデルが一体となって進化していくことが可能になる。
CPUの新たな経済学
資金は稼働率の高いところに集まる。NVIDIAは、インフラの重要な評価指標が「メガワットあたりのエージェントトークン数」へとシフトしつつあると指摘する。CPUがツールの起動、データの移動、あるいはオーケストレーション処理の完了を待っている間は、いくら高速なGPUであっても価値を生み出すことはできない。その待機時間中、高価な資産は有益な処理を行わないまま電力を消費し続けることになる。
ビジネスリーダーにとって、このトレンドは次の5つの問いを変化させる。
- インフラの購入担当者は、GPUの搭載数だけでなく、CPUとGPUの比率についても確認すべきである。
- エージェントを運用するチームは、CPUの処理時間やツールの実行時間を含めた、タスク全体の完了時間を測定すべきである。
- CFO(最高財務責任者)は、高価なGPUがシステムの他の部分の処理を待つために、どれだけの時間アイドル状態(待機状態)になっているかを調査すべきである。
- 開発者は、サンドボックスの起動、コンパイル、情報の検索、およびツールの呼び出しにかかる時間をプロファイリング(測定・分析)すべきである。
- 投資家は、アクセラレーターだけでなく、CPU、メモリ、およびオーケストレーション用ソフトウェアの動向にも注目すべきである。
もちろん、GPUは引き続き不可欠な存在だ。また、「AIブレイン(AI Brains)」の活用が拡大するにつれ、これがさらなる新たな変化をもたらす可能性もある。
今回の新たな教訓は、「AIファクトリーの生産性は、最も遅いコンポーネントによって決まる」ということだ。エージェントが「質問に答える」段階から「タスクを完遂する」段階へと移行する中で、彼らを動かし続ける鍵となるチップは、他ならぬCPUかもしれない。