

実際に買っているもの:チップ、電力、そしてCUDA
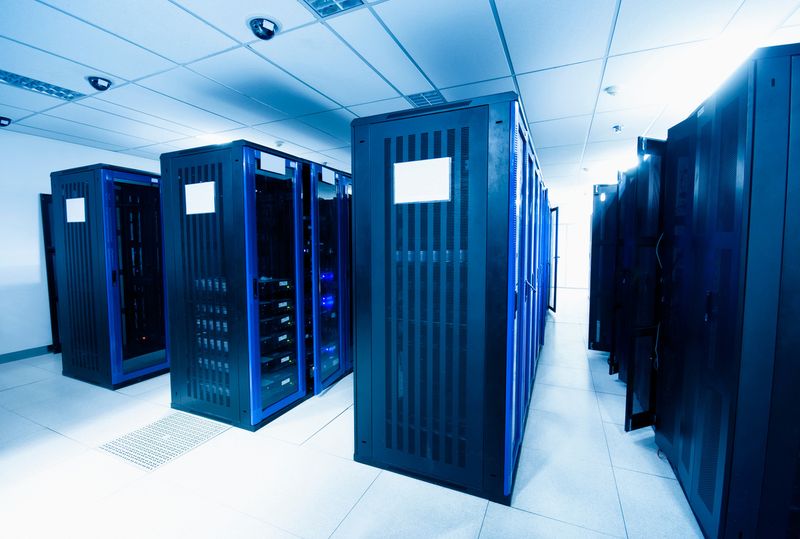
冒頭のリストに重み付けをしてみよう。GPU単体ではほとんど何もできない。すぐそばに高速メモリが必要で、何千台もと一体で動くためのネットワークが必要で、データを供給するプロセッサが必要で、その下に記憶装置が必要だ。さらに建物、電力、冷却設備。これら一式で施設を満たせば、エヌビディアが「AIファクトリー」と呼ぶものになる。一つの目的のために建てられ、非常に高価なハードウェアの核を包み込んだデータセンターだ。
さらにソフトウェアがある。買い手が過小評価するのがこの部分だ。CUDAと呼ばれるソフトウェア層も存在する。エンジニアがチップに直接触れることはない。彼らのコードはCUDAを経由してチップに到達する。これは技術的な細部ではなく、スイッチングコスト(乗り換えコスト)だ。買っているのはシリコンだけではない。エンジニアがすでに習熟し、コードがすでに前提としているツールチェーンごと買っている。
これらは同じ速度で古びるわけではない。建物は数十年もつ。冷却設備は何年も稼働する。疑問符が付くのはチップで、AIデータセンター全体のコストの約3分の2を半導体と関連部品が占める。だからこそ、変圧器を数えることがこの建設ラッシュを読み解く有用な手段になった。
長寿命の外殻が、高速で動く核を包み込んでいる。これは資産としてのコンピュートを理解する上で最も重要な事実であり、AI建設ラッシュに関するほぼすべての議論はここから派生する。
訓練と推論は、二つの異なる時間軸で動く
コンピュートは形の全く異なる二つの仕事をこなす。訓練はモデルを構築する作業で、1回の実行には区切りがある。巨大で高価だが、必ず終わる。推論は訓練済みモデルが回答を出す作業で、稼働中のサービスならば止まらない。回答一つひとつは小さいが、何百万人のユーザーに終日提供すれば、回り続ける計器になる。
これで古いチップの行き先が説明できる。訓練はピーク性能を求める。推論はそれより低くても、バッチ処理ならさらに低くても済む。だから、最初の仕事から引退したチップも、第二の仕事では十分に使える。
AIコンピュートの価格設定と販売方法
支払い方法は主に三つあり、その価格設定の背後で、どれもが同じ問いに答えている。この機械が来年、今日より価値が下がるリスクを、誰が引き受けるのか、という問いだ。
1. 買う。資産も問題も自分のものになる。
2. 時間単位で借りる。プレミアムを払い、老朽化の問題を他人に押し付ける。
3. ハードウェアを飛ばしてAPI経由でトークン単位に支払う。APIとは、機械を所有せずにモデル出力を購入できるソフトウェア接続だ。減価償却は一切引き受けない。コストが割高になるかは利用量次第で、需要が不規則なときは安く、恒常的なときは高くなる。
このトレードオフはめったに営業提案には出てこない。筆者が何度か目にした企業の失敗は、AIを所有する満足感のために自前のハードウェアを買うことだ。そして本来の性能のごく一部しか使わず、その間に機器は棚の上で静かに価値を失っていく。