

密な行列計算から分岐する推論へ、CPUの役割が変わる可能性
予想どおりというべきか、3月以降、このアームのニュースに関する続報はあまり見当たらない。ただ、デジタル主権を扱うメディアVucense(ビューセンス)のアンジュ・クシュワハが7月29日に公開した分析は見つかった。彼女はこの状況を次のように評している。
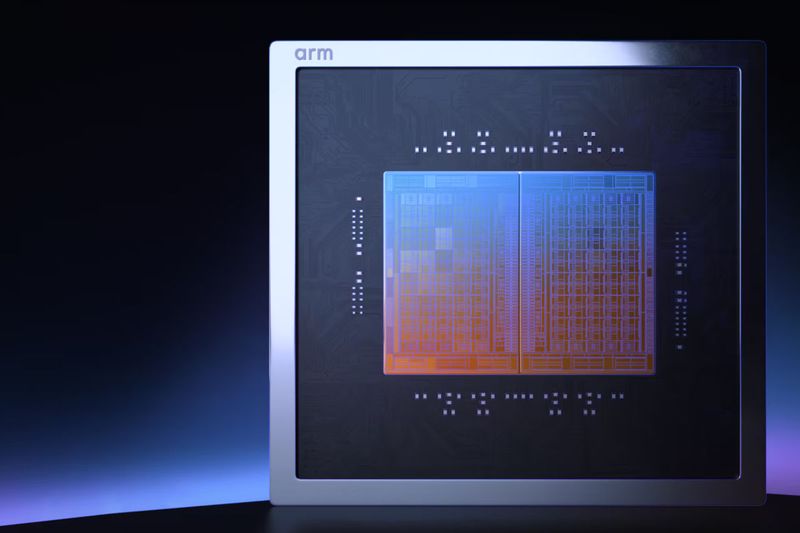
「インフラ部門の責任者は、自社が使うクラウド事業者について、独自仕様の半導体にどれだけ依存し、オープンな標準規格のハードウェアをどれだけ使っているかをもとに『主権スコア』を評価すべきである。(中略)この転換は、アームにとって『ライセンス供与だけ』の時代が終わったことを示している。アームは現在、2026年のAI計算市場の覇権をめぐって、エヌビディアやカスタムASIC(特定用途向け集積回路)の提供者と直接競合しているのだ」。
新規参入をめぐって繰り返し使われる、あの言い回しもここに出てくる。
「この動きは、チップの階層構造をめぐる主権にとって決定的な岐路となる。設計と現物の半導体の両方を押さえることで、アームはエヌビディアの支配に挑もうとしており、同時にクラウド事業者に対して、より統合された選択肢を差し出そうとしているのだ」。
ハードウェアの使い手が求めるものが変わりつつあるという点に踏み込んだクシュワハの分析のうち、私が気に入ったのは次のくだりだ。
「エヌビディアの支配は、巨大なテンソルコア(Tensor Core。行列演算に特化した専用回路)の上に築かれている。テンソルコアは、密な行列の掛け算、すなわち巨大な基盤モデル(Foundation Model)を学習させるために必要な力ずくの計算を、きわめて効率よくこなす。ところが2026年に入り、ボトルネックは学習から推論へと移った。自律的に動くAIエージェントは、密な行列を絶えず計算し続ける必要はない。必要なのは、分岐が何重にも入り組んだ『もしこうなら、こうする』という論理的な推論である。アームのSVE(Scalable Vector Extension。1度に処理するデータの長さを固定せず、動作中に変えられるベクトル演算の拡張命令)というアーキテクチャーがあるおかげで、AGI CPUはベクトル長をその場で動的に調整でき、次世代のトランスフォーマー型エージェントに見られる、まばらで予測しがたい活性化のパターンに合わせて最適化できる」。
つまり、行列の掛け算の重要性は下がっていくということなのか。
結局のところ、この一件がどう決着するのかは、見守るしかなさそうだ。技術者や経営陣が、カンファレンスの場で互いに問いかけ合うテーマにはなるだろう。続報を待ちたい。